Arquitectando para la Resiliencia en el Software Moderno
Principios clave de diseño e ingeniería para garantizar que los sistemas altamente distribuidos permanezcan tolerantes a fallos, auto-reparables y escalables frente a picos impredecibles de demanda.
En pocas palabras
- Patrones de resiliencia distribuida: Circuit Breakers, Bulkheads y aislamiento de fallos por servicio.
- Clean Architecture (Hexagonal) para aislar la lógica de dominio de cambios de infraestructura.
- Observabilidad tridimensional completa con métricas RED, logs JSON centralizados y trazas en Jaeger.
- Chaos Engineering en producción para validar proactivamente la capacidad de auto-recuperación.
En los sistemas distribuidos modernos, el fallo no es una posibilidad remota ni un evento extraordinario: es una certeza estadística que ocurre con una frecuencia predecible. Las redes experimentan latencia variable y pérdidas de paquetes. Los servicios de terceros sufren caídas y degradaciones sin previo aviso. Las bases de datos experimentan picos de contención bajo carga. Los certificados SSL expiran. Los contenedores se reinician. En un sistema con cien microservicios, si cada uno tiene un SLA de disponibilidad del 99.9%, la disponibilidad compuesta del sistema es aproximadamente del 90%. Sin diseño explícito de resiliencia, los fallos parciales se convierten en fallos totales.
La resiliencia no es una característica que se añade al final del proyecto; es una disciplina de diseño que impregna cada decisión arquitectónica desde el primer día. La base de un sistema verdaderamente resiliente es la separación estricta de responsabilidades mediante Clean Architecture —también conocida como Arquitectura Hexagonal o Puertos y Adaptadores—, que aísla las reglas de negocio centrales (el núcleo inmutable del dominio) de todas las dependencias de infraestructura (bases de datos, APIs externas, sistemas de mensajería, frameworks web). Cuando un proveedor de base de datos cambia o un API externa deja de responder, solo se reemplaza el adaptador externo; la lógica de negocio permanece completamente intacta y sin modificar.
Sobre esta base arquitectónica implementamos una batería de patrones de tolerancia a fallos probados en producción: Circuit Breakers para interrumpir automáticamente las solicitudes a servicios que están fallando (evitando que la latencia acumulada colapse los thread pools), Bulkheads para aislar grupos de hilo de ejecución por servicio (garantizando que el fallo de una integración no afecta a las demás), Throttling y Rate Limiting para proteger servicios downstream de picos de carga repentinos, y el Outbox Pattern para garantizar la consistencia eventual en arquitecturas de eventos asíncronos sin recurrir a transacciones distribuidas frágiles.
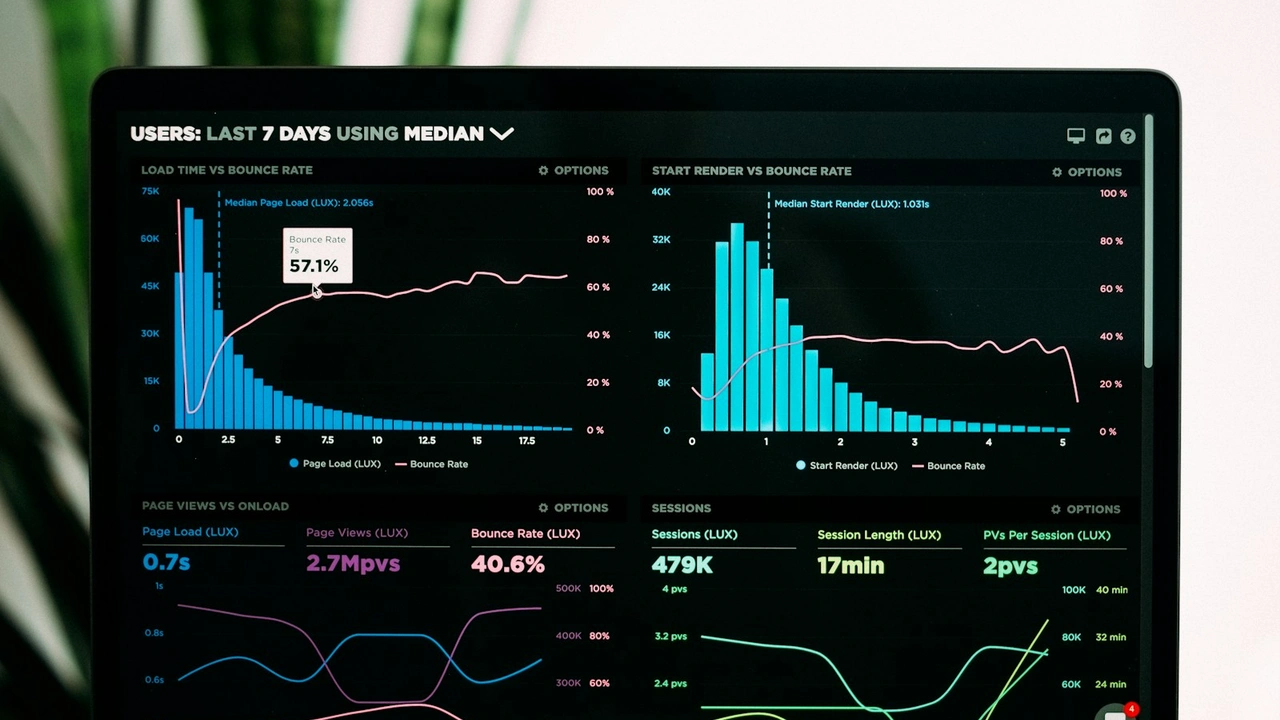
La validación de la resiliencia se realiza de manera proactiva, no reactiva. Implementamos observabilidad tridimensional completa con OpenTelemetry: métricas de RED (Rate, Errors, Duration) para cada servicio en Prometheus/Grafana, logs estructurados centralizados en Loki o Elasticsearch, y trazas distribuidas end-to-end en Jaeger o Tempo que permiten visualizar exactamente el recorrido de cada solicitud a través de todos los microservicios. Y vamos más lejos: practicamos Chaos Engineering de manera sistemática, inyectando fallos controlados en producción (latencia artificial, caídas de pods, particiones de red) para verificar que el sistema se comporte exactamente como fue diseñado cuando algo sale mal.
El Reto de la Complejidad Distribuida
En sistemas distribuidos a escala empresarial, el fallo de componentes individuales es completamente inevitable: es solo cuestión de cuándo, no de si ocurrirá. Las redes experimentan latencia variable y pérdidas de paquetes. Los servicios de terceros (proveedores de pago, APIs de geolocalización, servicios de identidad) sufren degradaciones sin previo aviso. La resiliencia no es reaccionar a incidentes cuando ocurren, sino diseñar el software desde cero para soportar fallos parciales de manera elegante, sin que un componente degradado provoque el colapso en cascada de todo el sistema. Un sistema resiliente falla silenciosamente en partes, no ruidosamente en su totalidad.
Principios de Arquitectura Limpia e Inversión de Dependencias
La Clean Architecture —también llamada Arquitectura Hexagonal o Puertos y Adaptadores— es el fundamento sobre el que construimos sistemas resilientes. El principio central es la Inversión de Dependencias: el núcleo de dominio (reglas de negocio) no depende de ningún framework, base de datos ni servicio externo. Son los adaptadores externos los que dependen del dominio, no al revés. Esto significa que la falla de un proveedor de base de datos, el cambio de un ORM o la sustitución de un broker de mensajería se limita completamente al adaptador correspondiente, sin tocar ni arriesgar la lógica de negocio central. Los sistemas construidos con este principio son inherentemente más fáciles de testear, modificar y mantener.
Patrones de Tolerancia a Fallos y Aislamiento
Implementamos un arsenal completo de patrones de resiliencia probados en producción. Circuit Breakers (implementados con Resilience4j o Polly) que detectan servicios degradados y abren el circuito automáticamente, devolviendo respuestas de fallback sin bloquear thread pools. Bulkheads que aíslan los grupos de threads por servicio externo, garantizando que el agotamiento de conexiones con un proveedor no afecte a los demás. Rate Limiting y Throttling adaptativos para proteger servicios downstream de picos de carga imprevistos. El Outbox Pattern para garantizar la consistencia eventual en eventos asíncronos: en lugar de publicar directamente en el broker de mensajes (arriesgando pérdida de mensajes si falla el broker), el evento se escribe atómicamente en la base de datos transaccional y un proceso Outbox lo publica de manera confiable.
Observabilidad Tridimensional y Chaos Engineering
La observabilidad es el sistema nervioso de la resiliencia. Desplegamos telemetría tridimensional completa con OpenTelemetry: métricas RED (Rate, Errors, Duration) por servicio en Prometheus con dashboards de Grafana, logs estructurados centralizados en JSON con correlación automática de trace IDs, y trazas distribuidas end-to-end en Jaeger que muestran visualmente el recorrido completo de cada solicitud. Sobre esta base de observabilidad, practicamos Chaos Engineering de manera sistemática con herramientas como Chaos Monkey, Chaos Mesh o Gremlin: inyectamos latencia artificial en llamadas inter-servicio, eliminamos pods aleatoriamente en horario de baja demanda y simulamos particiones de red. Si el sistema no sobrevive a estos experimentos en staging, no llega a producción.
La Resiliencia como Inversión de Negocio
El costo real de no diseñar la resiliencia desde el primer día se mide en minutos de caída multiplicados por el costo por minuto de inactividad. Para un e-commerce con ingresos de 100,000 USD diarios, un incidente de dos horas en Black Friday representa 8,300 USD de ingresos perdidos directos, más daño de marca incuantificable. Diseñar resiliencia desde el día uno —Circuit Breakers, Bulkheads, Chaos Engineering— es la inversión de arquitectura con el mayor retorno comprobado. El software verdaderamente resiliente garantiza la continuidad total de las operaciones durante picos de tráfico masivos, fallos de proveedores externos y eventos de infraestructura imprevistos, protegiendo tanto los ingresos como la confianza de los clientes.
¿Quieres aplicar esto en tu empresa?
Habla con un arquitecto de Nubework.